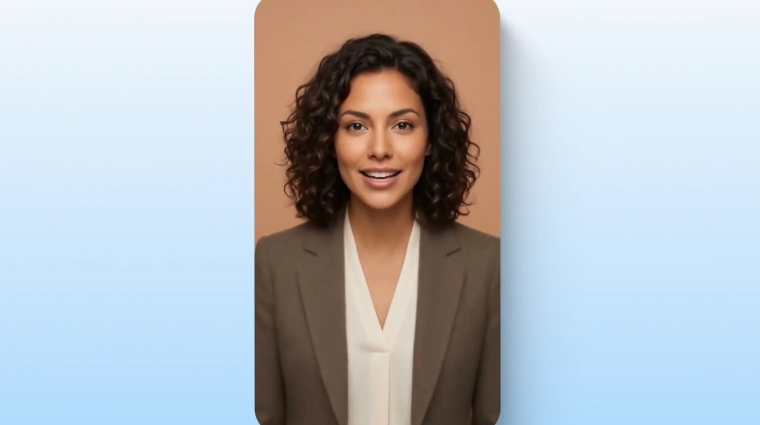
A Google új szintre emeli AI modellje élő beszélgetéseit, a Gemini Enterprise keretében elérhető Gemini 3.8 Live ugyanis már nemcsak felolvassa a válaszait, hanem egy kiválasztott avatár segítségével vizuálisan meg is jeleníti a beszélgetőpartnert. A rendszer valós idejű beszédet és alacsony késleltetésű videógenerálást kombinál, így tényleg úgy tűnik, mintha az avatár kimondaná a Gemini által generált szöveget - még akkor is, ha egyelőre elég fura összehatása van az egésznek.
A Google kutatói, Shuo-yiin Chang és CJ Zheng szoftvermérnökök szerint ezzel az AI sokkal erősebb "vizuális jelenlétet" kap. Az új funkciót elsősorban vállalati felhasználóknak szánják, a Google azonban nem feltétlenül azt képzeli el, hogy a cégek dolgozói beszélgetnek majd az avatárokkal, sokkal inkább az ügyfelek számára elérhető online szolgálatokban látják a technológia lehetőségét.
A vállalat szerint az avatárok többek között ügyfélszolgálatokon, recepciósként vagy oktatási és betanítási feladatoknál lehetnek hasznosak. A megjelenésük is testreszabható: induláskor egy előre elkészített könyvtárból lehet kiválasztani a nekünk tetszőt, de a vállalatok saját karaktert is készíthetnek (akár animációs figurákat, akár valós személyeket "bedigitalizálva"), például a cég arculatához illő ruházattal és logóval. A Gemini által létrehozott avatárvideókba a vállalat saját SynthID vízjeltechnológiája kerül, így később ellenőrizhető, hogy mesterséges intelligencia készítette-e az anyagot. A Google szerint ez segíthet a félretájékoztatás elkerülésében.
A Gemini 3.8 Live más területen is fejlődött: immár 97 nyelvet támogat, és képes automatikusan váltani a nyelvek között, így a többnyelvű beszélgetések is gördülékenyebbé válhatnak. A Google emellett bemutatta a Gemini 3.8 Live Extended Thinkinget is, ami a vállalat állítása szerint több benchmarkon is jobb eredményt ért el a GPT-Live-1 Astra és a Grok Voice Think Fast 2.0 modelleknél, miközben a bemeneti hanganyag feldolgozása óránként kevesebbe kerül.
Forrás: Techradar
